Shadow ouvre aux développeurs d’IA les cartes graphiques que ses utilisateurs laissent au repos en journée, avec Blade, une plateforme d’inférence.
Introduction
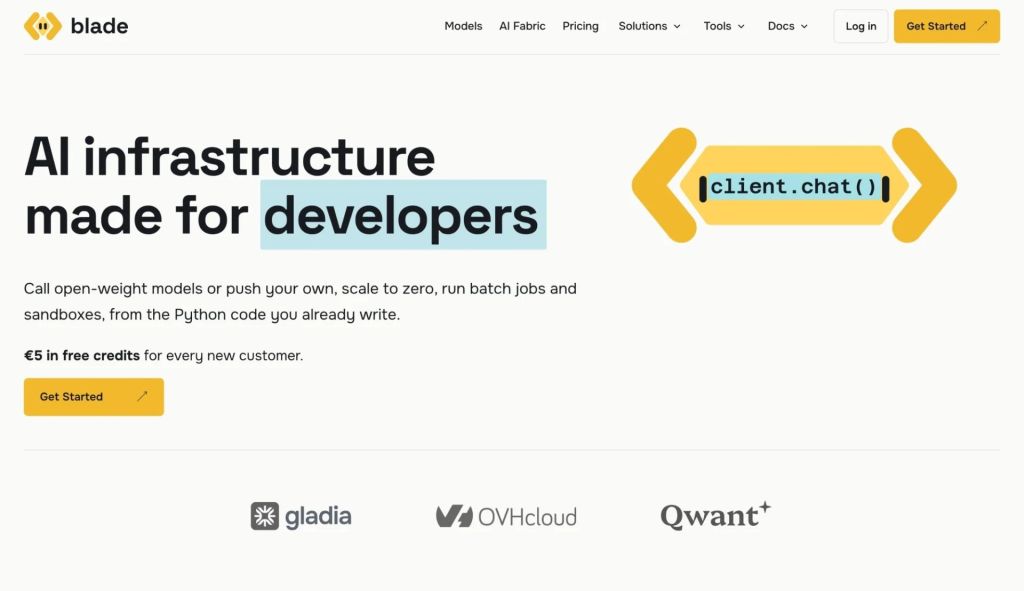
Le PC dans le cloud de Shadow ne tourne pas à plein régime du matin au soir, et l’entreprise a décidé d’en tirer parti. Il y a quelques jours, dans le cadre d’une conférence de presse en ligne, elle a présenté Blade, une plateforme accessible sur blade.sh. Elle s’adresse aux développeurs, aux startups et aux entreprises qui veulent exécuter des modèles d’IA et mettre leurs applications en production sans avoir à monter ni à gérer eux-mêmes une infrastructure GPU.
Le constat est parti du fait Shadow fait tourner aujourd’hui 12 000 cartes graphiques Nvidia pour alimenter les ordinateurs virtuels de ses utilisateurs, plusieurs dizaines de milliers de personnes réparties entre l’Europe et l’Amérique du Nord. Ces clients grand public, pour beaucoup des joueurs, se connectent surtout le soir et le week-end. Le reste du temps, une partie de cette capacité peut donc être réaffectée à des usages professionnels de l’IA. Petit clin d’œil à l’histoire maison, Blade était le nom de la société à ses débuts.
À partir de 1 479€
En stock
Acheter sur Fnac.com
Un catalogue de modèles tout de suite, le déploiement sur mesure en novembre
La première offre, Blade Models, est disponible dès le lancement. Elle donne accès par API à une vingtaine de modèles qui couvrent le texte et le code, la vision, la reconnaissance de caractères (OCR), la génération d’images et la transcription audio. Vous payez à l’usage, au million de jetons, et l’interface suit le standard d’OpenAI, ce qui doit faciliter le passage d’un fournisseur à l’autre.
AI Fabric, attendue courant novembre, va plus loin. Le développeur pourra y installer son propre modèle, son code ou son application, depuis son environnement Python ou en important un modèle depuis Hugging Face, sans jamais créer ni administrer de serveur ou d’instance GPU. Il choisit les ressources dont il a besoin, Blade les met à disposition et les orchestre, et le coût s’affiche en temps réel.
Shadow y greffe Staan, l’API de recherche web conçue par Qwant et Ecosia au sein de leur coentreprise European Search Perspective. Un modèle d’IA ignore tout ce qui s’est passé après la date où ses données ont été figées. Staan lui permet donc d’aller puiser sur le web des informations récentes, structurées et sourcées, de quoi nourrir du web grounding ou des architectures de génération augmentée par la recherche (RAG). Rappelons que Shadow et Qwant appartiennent tous deux à Synfonium, structure créée par Octave et Miroslaw Klaba, cofondateurs d’OVHcloud.
Des cartes RTX plutôt que des H100, un pari sur les petits modèles
Blade se concentre sur l’inférence, autrement dit l’exécution des modèles en production. Shadow ne prétend pas réinventer chaque brique et place sa différence dans leur assemblage au sein d’une plateforme qu’il veut simple, avec une facture lisible. L’entreprise se pose ainsi en contrepoint d’Amazon Web Services, Microsoft Azure et Google Cloud, qui fournissent surtout à ses yeux une infrastructure brute que le client doit configurer et administrer lui-même. Elle préfère d’ailleurs ranger Blade parmi les néoclouds, aux côtés de Nebius ou CoreWeave, plutôt qu’avec les hyperscalers.
Le matériel marque aussi la différence. Blade repose sur des cartes Nvidia RTX, issues du jeu et des stations de travail, et non sur les accélérateurs H100 ou B300 des grands centres de calcul dédiés à l’IA. Shadow présente ces cartes comme un atout dont ses concurrents néoclouds ne disposent pas, justifie ce choix par l’essor des petits modèles et affirme couvrir 80 à 90 % des cas d’usage, une estimation qu’il ne démontre pas. Une instance plafonne à huit GPU et les plus gros modèles, ceux qui comptent plusieurs centaines de milliards de paramètres, restent hors de portée. C’est au développeur de vérifier que son modèle tient dans la mémoire des cartes, quitte à le compresser, avec l’aide d’une estimation fournie dans la console. Dommage que Blade ne propose pas encore de base de données vectorielle intégrée. Il faudra la brancher sur une base existante, PostgreSQL avec pgvector par exemple.
Des prix qui suivent les heures creuses
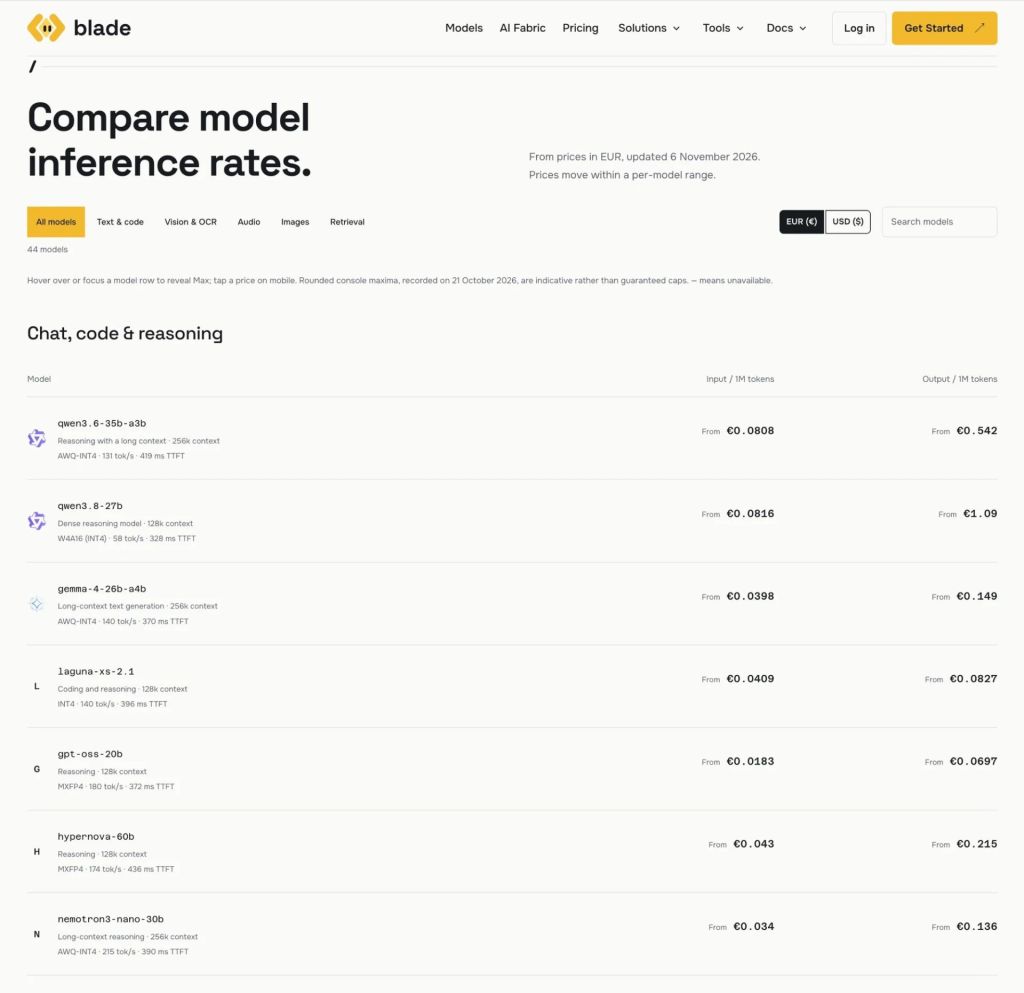
La logique du partage entre joueurs du soir et développeurs de jour se retrouve dans la grille tarifaire. Blade applique une tarification dynamique, calée sur la capacité disponible. Le prix est garanti pour la demi-heure à venir et un plafond est affiché, mais la page de tarification ne publie que des prix planchers. Les traitements qui peuvent attendre, comme les calculs par lots ou la génération de données synthétiques, se programment sur les créneaux les moins chers.
Shadow annonce des tarifs inférieurs de 25 à 40 % à ceux des principaux acteurs du marché sur des GPU équivalents, sans nommer ces concurrents ni détailler sa méthode. Notez que ni la sortie de données ni les services annexes ne sont facturés. Pour garder la dépense sous contrôle, il est possible de limiter le nombre de GPU qu’une application peut mobiliser, et une console de pilotage peut être confiée aux directions financières.
La souveraineté mise en avant
« L’Europe ne manque ni de talents ni de modèles d’IA », a déclaré Boris Lecoeur, directeur général de Shadow, au moment du lancement. Il cible notamment « des entreprises européennes qui sont soucieuses de faire tourner leur workload sur des infrastructures européennes contractualisées avec un acteur français non soumis au Cloud Act ».
Les clients peuvent effectivement choisir une infrastructure située en Europe, hébergée chez OVHcloud. Le détail mérite toutefois l’attention. Shadow occupe chez OVHcloud trois centres de données en Europe et trois aux États-Unis. La page consacrée au traitement des données indique que les GPU de Blade tournent en Europe, sans citer de pays ni préciser combien de temps les requêtes sont conservées. Le catalogue, lui, réunit surtout des modèles d’Alibaba, DeepSeek, Google, OpenAI et Nvidia, à côté de Mistral AI et Black Forest Labs, tous exécutés sur les machines de Shadow.
Blade vient donc prolonger l’activité historique de Shadow sans la remplacer, et Boris Lecoeur y voit sans surprise « un relais de croissance très important, un produit stratégique pour Shadow ». Pour démarrer, l’entreprise migre sur Blade les clients avec lesquels l’offre a été construite ces dix-huit derniers mois. Prochaine étape, AI Fabric, attendue courant novembre et facturée à la minute de GPU, processeur, mémoire et stockage compris, sans aucun frais lorsque l’application retombe à zéro.
Journaliste